Seit vielen Jahren arbeite ich dort, wo Finanzen, Reporting, Daten und große Transformationsprojekte zusammenkommen, und ich habe in dieser Zeit erlebt, wie weit sich die Technik entwickelt hat. KI verspricht nun den nächsten Schritt: Statt noch einen Bericht zu bauen, stellt man den Unternehmensdaten einfach eine Frage und bekommt eine Antwort. Die Vorführungen sind beeindruckend, aber eine Frage ist mir dabei immer wieder gekommen: Können wir den Zahlen eigentlich trauen?
Meine Sorge war nie, dass eine KI nicht rechnen kann. Sie war, dass viele Entscheidungen hinter einer betriebswirtschaftlichen Zahl nie wirklich Teil der Daten waren. Welches von drei Systemen gilt, wenn sie sich widersprechen? Ist der Export im Controlling die maßgebliche Quelle oder nur eine Kopie, die jemand aufgehoben hat? Was genau bedeutet „letztes Jahr“ in einem Unternehmen, dessen Geschäftsjahr von Mai bis April läuft? Ein System kann eine Zahl liefern, ohne eine dieser Fragen je beantwortet zu haben, und das fällt kaum auf, denn wer die falsche Tabelle erwischt, bekommt keine Fehlermeldung, sondern eine Zahl, die völlig normal aussieht.
Die Idee: erst die Daten prüfen, dann antwortet die KI
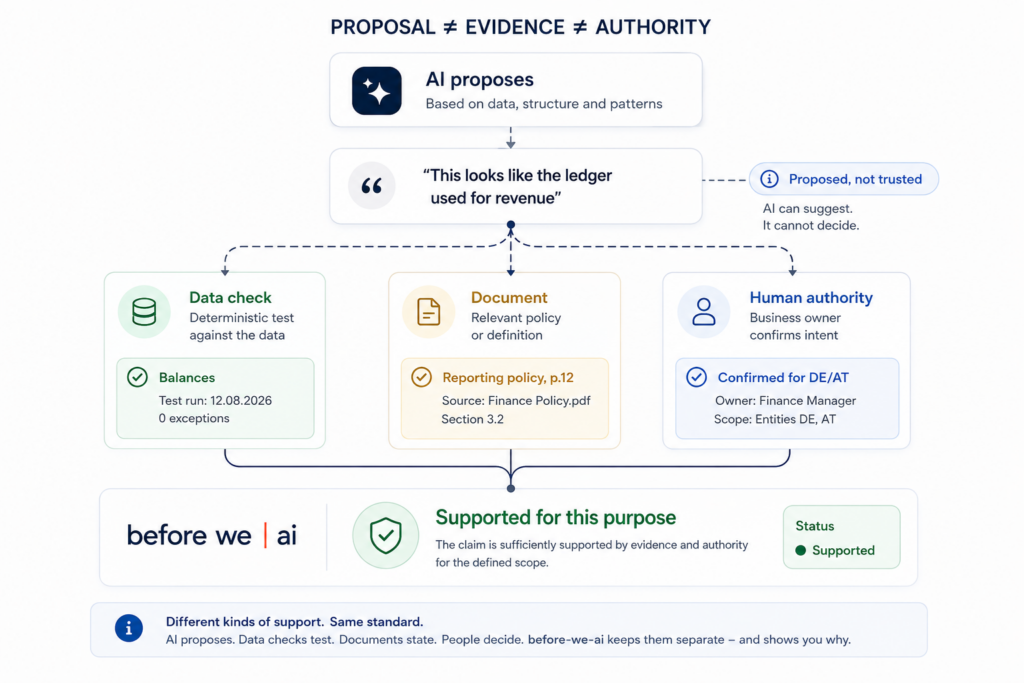
Aus dieser Sorge ist before-we-ai entstanden. Meine Überzeugung war damals, dass eine KI ihre eigene Arbeit nicht zuverlässig bewerten kann, weil derjenige, der eine Antwort erzeugt und sie dann selbst prüft, vor allem das sieht, was er erwartet. Deshalb wollte ich vor jeder KI-Analyse eine Prüfung der Daten haben, an deren Ende jemand bestätigt, dass die Daten gesichtet, geklärt und so beschrieben sind, dass eine KI sie versteht. Erst dann sollte die KI antworten dürfen, und daher kommt auch der Name.
Gebaut habe ich das als weitgehend regelbasiertes System. Jede Aussage über die Daten, etwa dass eine bestimmte Tabelle das Hauptbuch für die Umsatzberechnung ist, wurde zu einer Behauptung mit einem Status. Die KI durfte solche Behauptungen vorschlagen, bestätigen konnte sie aber nur eine feste, deterministische Prüfung oder ein Mensch. Am Ende wurde eine Frage als bereit, eingeschränkt bereit oder blockiert eingestuft, und im blockierten Fall war sichtbar, warum. Mit der Zeit wuchs das Projekt auf rund 16.000 Zeilen Code und knapp 900 Tests, und auf eine Kennzahl war ich besonders stolz: Die KI hatte nie selbst eine Behauptung bestätigt.
Dann habe ich gemessen
Was ich bis dahin nicht getan hatte, war, meinen Ansatz mit der naheliegenden Alternative zu vergleichen. Also habe ich dieselben Dateien und dieselbe Frage einem aktuellen Sprachmodell gegeben, ohne mein Regelwerk drumherum, und beide Ergebnisse mit einem Lösungsschlüssel verglichen, den ich vorher erstellt hatte. Außerdem habe ich vor dem ersten Lauf zwölf Vorhersagen aufgeschrieben, damit ich meine Erwartungen hinterher nicht stillschweigend anpassen konnte.
Die erste Testlandschaft bestand aus zehn Dokumenten eines fiktiven Schiffbauers, und die Frage betraf die erwarteten Kosten eines Schiffs. Mein Regelwerk antwortete mit „blockiert“: Keiner der 46 Punkte, die es für nötig hielt, war geklärt, und 46 Entscheidungen warteten auf einen Menschen. Nach seinen eigenen Regeln war das korrekt, aber es ist auch genau das, was eine Maschine sagt, die immer Nein sagt. Das Sprachmodell brauchte ungefähr zwei Minuten und lieferte sechs Zahlen, von denen fünf auf den Euro stimmten.
Die dritte Landschaft war bewusst unordentlich, und kein Dokument erklärte einen der Fehler, die darin eingebaut waren. Hier trafen drei Läufe des Sprachmodells den Jahresendsaldo exakt und fanden alle 18 eingebauten Fehler, während mein Regelwerk sieben davon klar erkennbar machte. Von meinen zwölf Vorhersagen erwiesen sich sieben als falsch, und alle lagen in dieselbe Richtung daneben: Ich hatte die KI unterschätzt.
Regeln sind nicht automatisch besser
Die wichtigste Erkenntnis für mich ist, dass eine regelbasierte Prüfung nicht automatisch zuverlässiger ist als eine KI, nur weil sie deterministisch arbeitet. Ich wollte die KI aus dem Aufbau des Kontextes heraushalten, aber die Daten zu verstehen ist die eigentliche Aufgabe: welche Tabelle das Journal ist, was eine Spalte bedeutet, ob ein Datensatz ein Duplikat oder eine Teillieferung ist. Wer das klären will, steckt schon mitten in der Analyse. Entweder entscheidet ein Mensch jede einzelne Zuordnung, und genau das hat mein Regelwerk verlangt, oder man verlässt sich bereits beim Aufbau des Kontextes auf die KI, also genau bei dem, was man eigentlich prüfen wollte. Auf meinen Testdaten war die KI darin besser und schneller als jedes Regelwerk, das ich von Hand hätte aufstellen können.
Ganz unbegründet war mein Misstrauen allerdings nicht. Beim Schiffbauer habe ich das Sprachmodell fünfmal laufen lassen, und alle fünf Läufe waren sich auf den Euro einig, auch bei der einen Zahl, die falsch war. Dass eine KI mit sich selbst übereinstimmt, beweist also nichts, und welche Antworten stimmten, wusste ich nur, weil ich den Lösungsschlüssel hatte. Die Prüfung bleibt deshalb wichtig, sie gehört aber hinter die Antwort und nicht davor. Jede Korrektur, die die KI vornimmt, lässt sich als Behauptung festhalten und gegen die Daten nachrechnen, und am Ende unterschreibt jemand die Antwort und nicht die Daten.
Wohin sich das entwickelt
Ich gehe außerdem davon aus, dass mit den weiteren Fortschritten der Modelle auch die Datenprüfung selbst immer mehr von KI übernommen wird. Schon heute kann eine KI vorschlagen, welche Prüfungen sinnvoll sind, sie schreiben und ausführen und die gefundenen Ausnahmen erklären, und das schneller, als ich Regeln formulieren kann. Was beim Menschen bleibt, ist nicht die einzelne Prüfung, sondern der Rahmen darum: zu wissen, welche Frage wir eigentlich stellen, wie ein richtiges Ergebnis ungefähr aussehen müsste und woran wir es erkennen, und wer am Ende die Verantwortung für die Antwort übernimmt.
Das gilt auch für mich persönlich. Ich habe before-we-ai mit einer KI als Sparringspartner entwickelt, und im Rückblick war das ein Teil des Problems. Einen Weg mit einer KI zu verfeinern und ihn dann gemeinsam zu gehen, ist eine großartige Art zu arbeiten, den Weg mit ihr zu suchen, ist dagegen riskant. Es ist ein bisschen wie beim Wandern: Die Route plane ich selbst, und dann kann ich sie mit jemandem gehen und unterwegs korrigieren. Plane ich sie nicht, laufe ich begeistert los und übersehe leicht das Offensichtliche. In meinem Fall war das Offensichtliche, dass es inzwischen effizienter ist, Kontext mit KI zu erarbeiten und zu prüfen, als Regeln von Hand aufzustellen, und ich hätte festlegen müssen, was am Ende herauskommen soll und woran ich erkenne, ob es stimmt, bevor die erste Zeile Code entstand.
Was „Before we AI“ für mich heute heißt
Aus der Datenprüfung ist ein „After the AI“ geworden. Der Name ergibt für mich trotzdem weiterhin Sinn, nur auf andere Weise: Bevor ich mit KI arbeite, mache ich meine Hausaufgaben. Ich weiß, was ich bauen will, wie der Ablauf aussieht, was zumindest zum großen Teil herauskommen soll und wie ich das Ergebnis überprüfe. Das ist keine Aufgabe, die ich delegieren möchte.
Eine Einschränkung gehört dazu. Meine Testdaten waren synthetisch und klein, und zwei der drei Landschaften hat ein Sprachmodell gebaut, bevor ein Modell derselben Familie sie gelöst hat. Auf einer echten, gewachsenen Unternehmenslandschaft habe ich nichts davon gemessen, es sind also eigene Experimente und kein Beweis. Sie haben mir aber gereicht, um das Projekt vorerst ruhen zu lassen und einige meiner Annahmen zu überdenken.
Ich habe ein Regelwerk gebaut, um die KI von Daten fernzuhalten, die sie nicht versteht. In meinen Tests hat sie die Daten besser verstanden als mein Regelwerk, und was ich zuerst hätte klären müssen, waren nicht die Daten, sondern mein eigener Plan.
Code, Testdaten, alle Vorhersagen samt der falschen und die Antworten der KI im Wortlaut liegen auf GitHub: github.com/happychriss/before-we-ai (Zweig case-study).